Bei uns schreiben Agenten inzwischen einen ordentlichen Teil des neuen Codes. Das geht schnell. Sehr schnell. Und wir machen das, obwohl (oder gerade weil?) wir erfahrene Entwickler mit teils 15+ Jahren in der Industrie sind.
Das Problem kommt danach, beim Pull Request. Der geht entweder nicht schnell, oder er ist nicht gründlich genug, oder es fehlt schlicht das Verständnis. Ich saß zuletzt öfter vor einem Diff mit 900 Zeilen, den niemand im Team selbst getippt hatte, und habe mich gefragt: Wer versteht das hier eigentlich gerade? Ehrlich gesagt: Ich nicht mehr. Und weil ich nicht so das passive Team-Mitglied bin, musste eine Lösung her :D
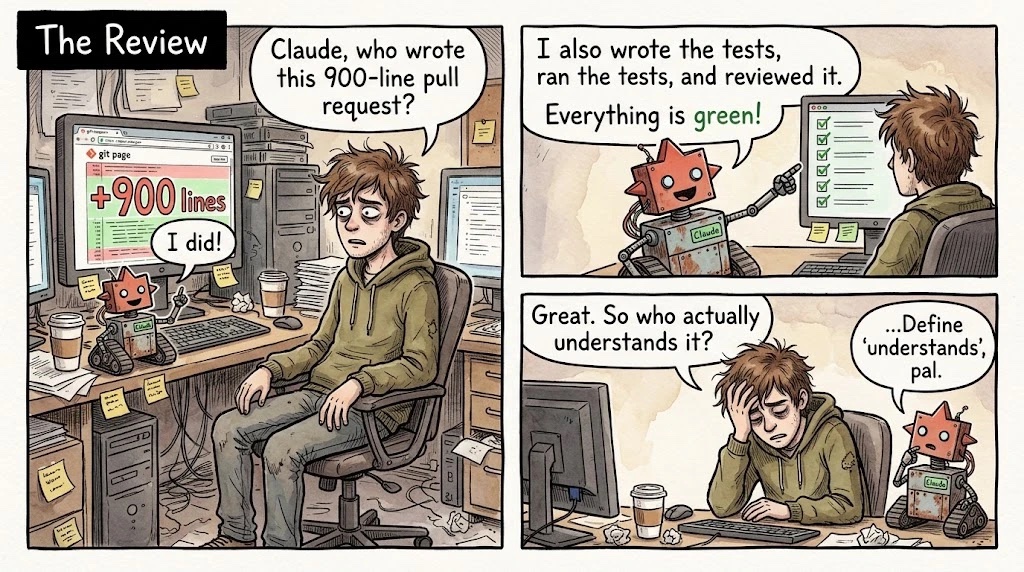
Wir haben aber nun mal 2026. Also habe ich drei KIs (Claude, ChatGPT, Gemini Argon) unabhängig voneinander recherchieren lassen, meine eigenen Erfahrungen dazugepackt, alles zusammengeworfen und die strittigen Zahlen in den Originalquellen nachgelesen. Schöne neue Welt...
Hier die Kurzfassung.
Die Arbeit hat sich verschoben
Wir schreiben mehr Code, liefern aber kaum mehr aus. Der DORA-Report 2025 (rund 5.000 Befragte) sieht mit KI mehr Durchsatz und gleichzeitig mehr Instabilität. DORA nennt den Mehraufwand fürs Prüfen "verification tax". Telemetrie von Faros AI (über 10.000 Entwickler, Herstellerdaten, also mit Vorsicht genießen) zeigt den Mechanismus: 98 % mehr gemergte PRs, PRs 154 % größer, Review-Zeit plus 91 %, auf Firmenebene kein Gewinn.
Dabei ist der DORA-Report von 2025, und allein in den letzten sechs Monaten haben wir mit Opus 5, Fable & Co. riesige Sprünge gemacht. Ich vermute allerdings, dass sich die Schere seitdem eher weiter geöffnet hat. Die Agenten schreiben schneller, gelesen wird immer noch im selben Tempo.
Der Flaschenhals ist also vom Tippen zum Lesen gewandert.
Dass ich damit nicht allein bin, zeigt gerade ein Ask HN mit Hunderten Kommentaren zur Frage, wie man mit KI-Code umgeht, den man selbst nicht versteht. Auslöser war ein Meta-Engineer, dem sein eigener Code inzwischen wie eine Blackbox vorkommt. Ein Senior-Entwickler mit zehn Jahren Erfahrung schreibt dort, dass bei Tausenden geänderten Zeilen pro Woche niemand mehr ernsthaft reviewen kann, und fasst den eigenen Alltag so zusammen:
"I just approve PRs, because I have to."
Genau da will ich nicht landen. Die Antwort ganz oben im Thread ist übrigens ziemlich genau meine Station 1 weiter unten: Das Design macht der Mensch, der Agent füllt nur die Lücken.
Drei Sorgen, die ich habe
1. Wir verlieren das Verständnis für unseren eigenen Code. Peter Naur hat 1985 in Programming as Theory Building geschrieben, ein Programm sei eine Theorie im Kopf des Teams: warum es so gebaut ist und wie es auf Änderungen reagiert. Diese Theorie entstand früher nebenbei, beim Schreiben. Wenn ein Agent plant, schreibt und testet, fällt das weg. In einer randomisierten Studie von Anthropic (52 Entwickler, Januar 2026) schnitt die KI-Gruppe beim Verständnis 17 % schlechter ab. Spannend ist der Unterschied innerhalb der Gruppe: Wer sich von der KI Dinge erklären ließ, landete bei 65 bis 86 %. Wer einfach delegierte, bei 24 bis 39 %. Dafür gibt es inzwischen sogar einen Namen: "comprehension debt", also Code, den das Team akzeptiert hat, bevor ihn jemand erklären kann.
2. Sicherheit. Veracode hat über 100 Modelle getestet: Ohne Sicherheitshinweise im Prompt enthielten 45 % der Beispiele eine bekannte Schwachstelle, und das wurde über die Modellgenerationen nicht besser. Dazu kommt ein schöner neuer Angriff: Knapp 20 % der von KIs vorgeschlagenen Pakete existieren gar nicht, und viele der erfundenen Namen tauchen bei jedem Lauf wieder auf. Angreifer registrieren die einfach vorab ("slopsquatting"). Und im April 2026 wurde gezeigt, dass Prompt Injection in PR-Titeln und Kommentaren mehrere KI-Review-Bots dazu bringt, CI-Secrets auszuplaudern.
Wie das im Großen aussieht, kann man sich übrigens öffentlich anschauen. Der Issue-Tracker von Claude Code (CLI und Desktop-App), einem Projekt, das zu einem großen Teil von seinem eigenen Agenten geschrieben wird, hat Stand heute rund 14.700 offene Issues bei etwa 86.000 geschlossenen. Gut jedes siebte Issue ist also noch offen. curl, ganz oldschool von Menschen gepflegt, liegt bei 15 offenen zu rund 5.600 geschlossenen. Das ist kein sauberer Vergleich (Nutzerzahl, Alter, Release-Takt sind völlig verschieden), aber es passt schon sehr gut zu meinem Bauchgefühl.
3. Verantwortung. Die KI hilft beim Review, aber nicht besonders gut. Auf SWR-Bench (1.000 echte PRs) kam das beste Tool auf einen F1-Score von 19 %. Wichtig: Das Paper ist von September 2025, getestet wurden also Modelle, die heute schon wieder zwei Generationen alt sind. Die Zahl ist inzwischen sicher besser, aber von einem verlässlichen Gate ist sie trotzdem weit weg. In einer Studie über 178 Repos führten 1 bis 19 % der KI-Kommentare zu einer Codeänderung, bei menschlichen Kommentaren waren es 60 %.
Der Linux-Kernel hat das 2026 sauber geregelt: Eine KI darf kein Signed-off-by setzen, der Mensch, der einreicht, steht für alles gerade. Das ist auch der einzige Weg, der funktioniert. Weder OpenAI noch Anthropic übernehmen Verantwortung für den Code, den ihre Modelle generieren. Wer ihn eincheckt, dem gehört er.
Was ich daraus mache
Den Pull Request behalten, ihm aber einen neuen Job geben. Ein PR ist für mich jetzt ein Paket, das ein Mensch prüfen kann: Was soll passieren, woran sehe ich, dass es funktioniert, wo ist das Risiko, und wer steht dafür gerade.
Und ein PR muss wieder Verständnis erzeugen, so wie früher nebenbei beim Schreiben. Das passiert nur, wenn der menschliche Autor die Arbeit der KI selbst durchgeht und redigiert, bevor jemand anders draufschaut. Wer den PR einfach weiterreicht, schiebt das Verstehen nur zum Reviewer, und der hat genauso wenig Kontext.
Dafür fünf Stationen:
- Absicht zuerst. Bevor ein Agent loslegt, gibt es ein Ticket mit Akzeptanzkriterien, Invarianten und dem, was ausdrücklich nicht dazugehört. Sonst prüft eine KI am Ende den Code gegen sich selbst.
- Selbstcheck des Autors. Ganzen Diff lesen, umbauen, was nicht passt. PR-Beschreibung in eigenen Worten. KI-Nutzung mit einem
Assisted-by-Trailer markieren. - Automatische Gates. Tests, Typen, Linter, SAST, Secret-Scanning, Dependency-Checks (existiert das Paket überhaupt, wie alt ist es).
- KI-Review. Läuft in einer Sandbox ohne Secrets, schreibt Kommentare, darf aber nichts freigeben.
- Mensch reviewt und merged. Wie gründlich, hängt vom Risiko ab. Doku und Formatierung: ein Reviewer reicht. Auth, Krypto, personenbezogene Daten, CI/CD: Code-Owner oder Security-Review, ohne Ausnahme.
Dazu ein paar Regeln, die ich ziemlich ernst meine:
- Wer die wesentliche Logik seiner Änderung nicht erklären kann, bekommt den PR zurück. Egal, wer ihn geschrieben hat.
- Ein Approve heißt: "Ich könnte das warten." Er heißt nicht "Die CI war grün", und erst recht nicht "Die KI fand's gut".
- PRs bleiben klein. Google hält etwa 100 Zeilen für vernünftig und 1.000 für zu viel. Ich starte mit einer weichen Grenze bei rund 400 Zeilen.
Mist rein, Mist raus
Ein Agent arbeitet nur so gut wie das Ticket, das er bekommt. Bei Menschen war das übrigens nie anders. Neu ist, dass die meisten Modelle nicht von selbst merken, wenn Informationen fehlen. Dürfen sie Rückfragen stellen, steigt die Leistung laut Ambig-SWE um bis zu 74 %.
Ich schreibe selbst keine Tickets, aber so wünsche ich sie mir: geschrieben für zwei Leser. Die Kollegin, die nächstes Jahr dazukommt, und einen Agenten, der nichts außerhalb des Repos kennt.
Konkret heißt das: Module und Dateien nennen, auf die bestehende Implementierung verweisen, der gefolgt werden soll, Qualitätsziele in Zahlen fassen ("unter 16 ms", nicht "schnell") und dazuschreiben, wie man es prüft.
Und ganz wichtig: Entscheidungen gehören ins Ticket oder in ein ADR, sobald sie fallen. Chat-Verläufe und Agenten-Sessions sind irgendwann weg, und die Begründung gleich mit.
Fazit
Ich kann schonmal garantieren, dass folgendes in einem Post-Mortem nicht klappen wird: "Das hat die KI geschrieben". Genauso wenig wird "Eine andere KI hat's reviewt" funktionieren.
Das heißt für mich: Die Werkzeuge dürfen so viel schreiben, wie sie wollen. Verstehen und unterschreiben muss es ein Mensch.
Ich bin gerade dabei, das Vorgehen meinem Team vorzuschlagen, und wir probieren es hoffentlich die nächsten Wochen aus. Mit Zahlen vorher und nachher: Review-Zeit, PR-Größe, Fehler nach dem Merge und ob ein zweiter Entwickler eine kritische Änderung erklären kann. Wenn es Ergebnisse gibt, schreibe ich darüber.
Quellen (Auswahl)
- DORA, State of AI-assisted Software Development 2025
- Anthropic, How AI assistance impacts the formation of coding skills, Januar 2026
- Comprehension-Debt-Studie, arXiv:2607.10856, 2026
- Spracklen et al., We Have a Package for You!, USENIX Security 2025
- Zeng et al., SWR-Bench, arXiv:2509.01494
- Sun et al., Does AI Code Review Lead to Code Changes?, arXiv:2508.18771
- Vijayvargiya et al., Ambig-SWE, arXiv:2502.13069
- Naur, Programming as Theory Building, 1985
- Linux-Kernel,
Documentation/process/coding-assistants.rst